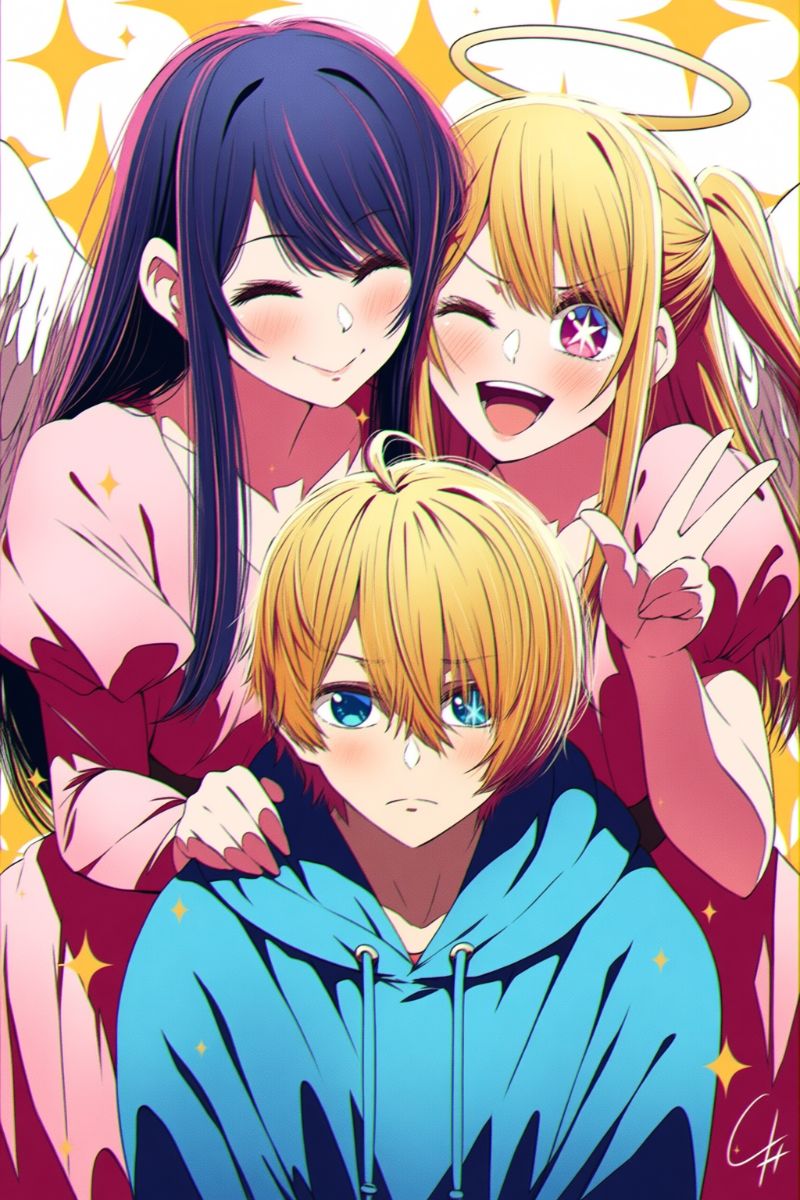
AnimaYume:高清动漫文生图,稳定输出少伪影
了解 AnimaYume 动漫文生图模型,它基于 Anima 微调,支持768至1280分辨率训练,适合高分辨率动漫图像生成。本文说明版本迭代、提示词理解改进、适用场景和上手提示,供动漫插画创作者选择参考。页面梳理 v0.4 与 v1.0 特性,帮助规划大尺寸插画工作流。
查看原文 →内容为平台聚合整理,原文与最新动态以来源页面为准。
 扫码进学习交流群
 加专属老师微信
图文介绍
模型定位
AnimaYume 是一款由第三方开发者基于 Anima 微调而来的动漫风格文生图 Checkpoint 模型。Anima 由 CircleStone Labs 开发,底层基于 NVIDIA 研究团队的 Cosmos 2 模型。该模型主要面向高分辨率动漫图像生成,通过多个版本迭代不断优化画质稳定性、提示词理解能力和风格表达。
核心功能亮点
- 版本迭代成熟:从 v0.1 到 v1.0,逐步解决高分辨率伪影、过饱和、黑边/白边、质量不稳定等问题,并在 v0.25/v0.3 中尝试多分支训练方式。
- 高分辨率表现稳定:从 v0.1 起训练分辨率覆盖 768-1280,示例图多用 1024×1536 或 1536×1024 输出,适合大尺寸插画场景。
- 提示词理解增强:v0.4 改善提示词响应与艺术家风格还原;v1.0 支持 chain-of-thought 提示词,可尝试更自然的语言描述。
- 数据范围更广:引入 Danbooru、e621、Gelbooru、Konachan 等数据集,补充新角色与画师风格知识,同时兼顾原有模型能力。
适用场景
- 动漫插画、角色概念设计、视觉封面与海报生成
- 需要 1024×1536 等大尺寸精细输出的图像创作
- 探索标签式提示词与自然语言描述组合对生成效果的影响
上手提示
- 注意分支差异:v0.25 与 v0.3 训练思路不同,v1.0 Demo 与 Final 也不适合直接比较,可按具体需求选择版本。
- v1.0 Final 自带内置水印,但不影响生成图像效果;该版本没有默认画风,请通过提示词明确所需的风格。
- 可参考作者发布的示例图设计提示词,其中部分来自 CivitAI 用户真实输入,对实际测试和调试有参考价值。
作者/来源:duongve13112002
常见问题
AnimaYume 从 v0.1 版本起训练分辨率覆盖 768 至 1280 像素,示例图多为 1024×1536 或 1536×1024 输出,适合大尺寸动漫插画、封面与海报场景。
AnimaYume 是第三方开发者基于 Anima 微调而成的动漫文生图 Checkpoint 模型。Anima 底层来自 NVIDIA 研究团队的 Cosmos 2 模型。AnimaYume 重点优化高分辨率图像稳定性、减少伪影,并持续改善提示词理解能力。
v1.0 Final 自带内置水印,但不影响生成图像效果。该版本没有默认画风,需要通过提示词明确指定风格。同时,v1.0 支持 chain-of-thought 提示词,可以尝试更自然的语言描述。
建议先根据输出尺寸和画风需求确定版本。v0.25 与 v0.3 训练思路不同,v1.0 Demo 与 Final 也不适合直接比较。可参考作者发布的示例图,其中部分来自真实用户输入,对测试和调整提示词有参考价值。