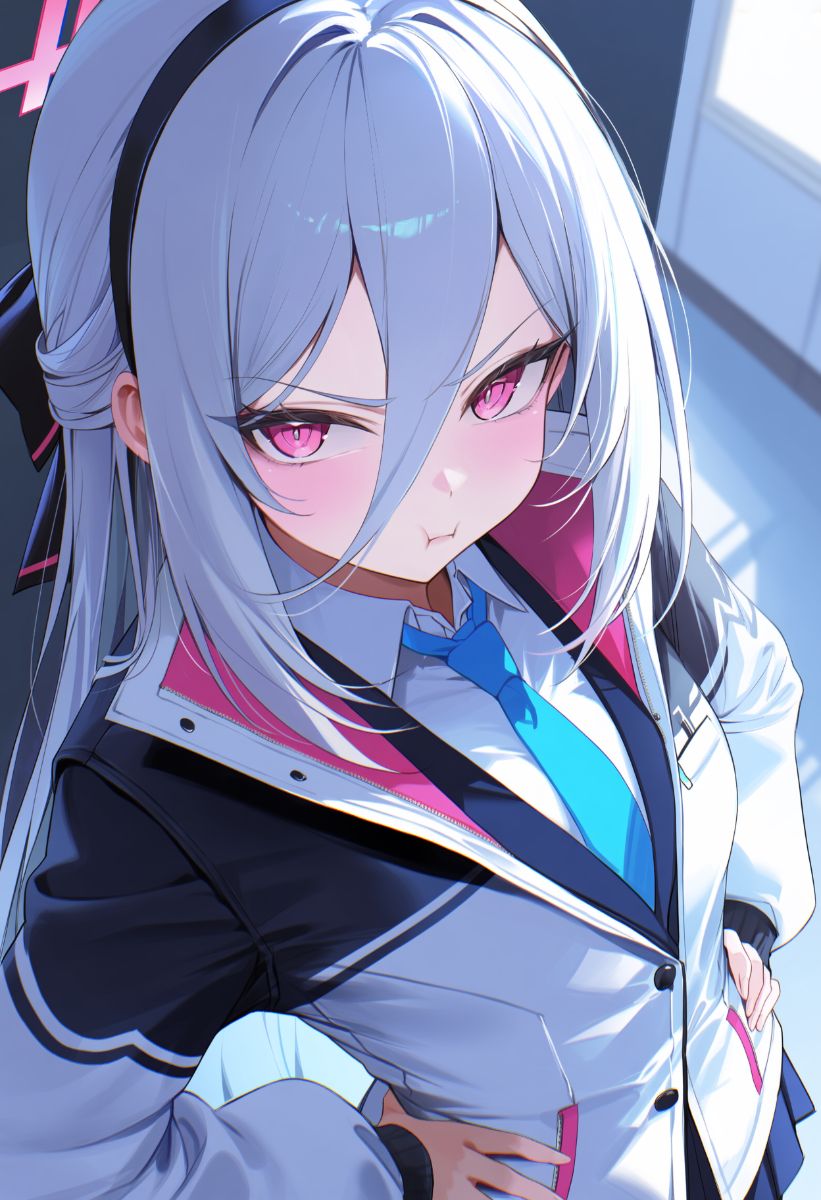
JANIMA:高质量动漫图像模型,细节锐利线条干净,构图更清晰
JANIMA 是基于 Anima 微调的动漫图像模型,2B 参数,细节锐利、线条干净、构图清晰,支持 LoRA 与风格适配器扩展。本文介绍适用场景、ComfyUI 模型放置与安装路径、推荐采样器 er_sde 与步数参数,以及质量标签和负面提示词,帮助你搭建动漫插画生成工作流。
查看原文 →内容为平台聚合整理,原文与最新动态以来源页面为准。
 扫码进学习交流群
 加专属老师微信
图文介绍
JANIMA 是一个高质量文本到图像(text-to-image)模型,基于 CircleStone Labs 与 Comfy Org 共同开发的 anima-base-v1.0 微调而来,拥有 2B 参数,专注于动漫与插画风格。该 Checkpoint 在保持 Anima 对动漫和风格化绘图灵活性的同时,优化了细节清晰度、解剖结构和画面构图。
项目/模型定位
- 面向高细节动漫角色、插画及风格化视觉内容。
- 主要服务动漫/非写实创作流程,不追求图像真实感。
- 作为基础 Checkpoint,适合叠加 LoRA 和风格适配器扩展表现。
核心功能亮点
- 同一分辨率与步数下,边缘、纹理和微细节表现更精细,线条干净,眼睛与面部特征清晰。
- 背景和微小物体细节更丰富,通常无需重度后期处理。
- 不强制单一风格,保留 Anima 模型的灵活度与创作空间。
适用场景
- 高细节动漫角色与插画创作。
- 需要干净线条、清晰五官和丰富背景的视觉内容。
- 在 ComfyUI 工作流中搭配 Anima 生态工具使用。
上手提示
- 模型放置:将 JANIMA_v1.safetensors 放入 ComfyUI/models/diffusion_models;qwen_3_06b_base.safetensors 放入 text_encoders;qwen_image_vae.safetensors 放入 vae。
- 推荐参数:采样器使用 er_sde;CFG 建议约 5;步数 24–30,若不做高清放大可增至 50;分辨率支持 512×512 至 1536×1536 范围。
- 质量标签:可在提示词前添加 masterpiece、highres、absurdres、newest、best quality、score_7 等标签,有助于生成更干净的输出。
- 负面提示词:建议使用 worst quality, low quality, lowres, score_1, score_2, score_3, blurry, jpeg artifacts, long fingers, bad anatomy, missing fingers, watermark。
- 社区资源:可参考 Anima Preview Workflow(Civitai)、Anima Style Explorer(4 万多个艺术家标签视觉库)、Animadex(角色与标签指南)。
预览图均为模型原始输出,未做过度修饰,可在推荐设置下直观了解生成效果。
作者/来源:janxd
常见问题
JANIMA 是基于 Anima 微调的动漫图像模型,拥有 2B 参数,定位动漫与插画风格。它适合高细节动漫角色、插画及风格化视觉内容创作,在动漫/非写实工作流中可以作为基础 Checkpoint 使用。
将 JANIMA_v1.safetensors 放入 ComfyUI/models/diffusion_models,qwen_3_06b_base.safetensors 放入 text_encoders,qwen_image_vae.safetensors 放入 vae,之后在 ComfyUI 中加载对应节点即可。
推荐使用 er_sde 采样器,CFG 约 5,步数 24–30;若不做高清放大可增至 50。分辨率支持 512×512 至 1536×1536。
支持。JANIMA 作为基础 Checkpoint,保留 Anima 的灵活性,适合叠加 LoRA 和风格适配器扩展表现,用户可据此调整角色或画风。
JANIMA 是基于 anima-base-v1.0 微调而来的模型,在保留 Anima 对动漫与风格化绘图灵活性的同时,优化了细节清晰度、解剖结构和画面构图。